引言
在大数据时代,海量数据的存储与处理成为企业面临的核心挑战。Hadoop作为Apache基金会下的开源分布式计算框架,凭借其高可靠性、高扩展性和低成本特性,成为大数据生态的基石。本指南将带你从零开始认识Hadoop,理解其核心组件,并逐步构建属于自己的数据存储与处理框架。
一、Hadoop是什么?
Hadoop是一个由Java编写的开源软件框架,允许在计算机集群上使用简单的编程模型对大规模数据集进行分布式存储和分布式处理。它起源于Google的GFS和MapReduce论文,如今已发展成包含HDFS、MapReduce、YARN等模块的完整生态。
二、Hadoop核心组件
1. HDFS(Hadoop Distributed File System)
HDFS是Hadoop的分布式文件系统,负责数据的存储。它具有高度容错性,设计用于运行在廉价商用硬件上。HDFS采用主从架构:
- NameNode:管理文件系统的命名空间和元数据。
- DataNode:实际存储数据块,默认每个块128MB,多副本存储(默认3副本)保证可靠性。
2. MapReduce
MapReduce是一种分布式计算模型,用于大规模数据集的并行处理。它将任务分为Map(映射)和Reduce(归约)两个阶段,开发者只需实现map和reduce函数,框架自动处理任务调度、容错和节点间通信。
3. YARN(Yet Another Resource Negotiator)
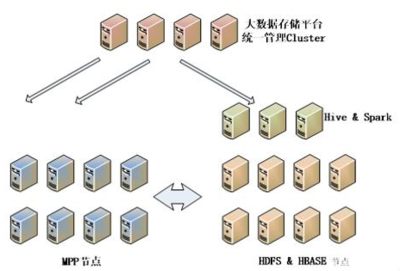
YARN是Hadoop的资源管理平台,负责集群资源的管理和调度。它将资源管理和作业调度分离,支持多种计算框架(如MapReduce、Spark、Flink)运行在同一个集群上。核心组件包括ResourceManager和NodeManager。
4. Hadoop Common
提供其他模块所需的公共工具,如配置、序列化、文件系统抽象等。
三、Hadoop生态系统
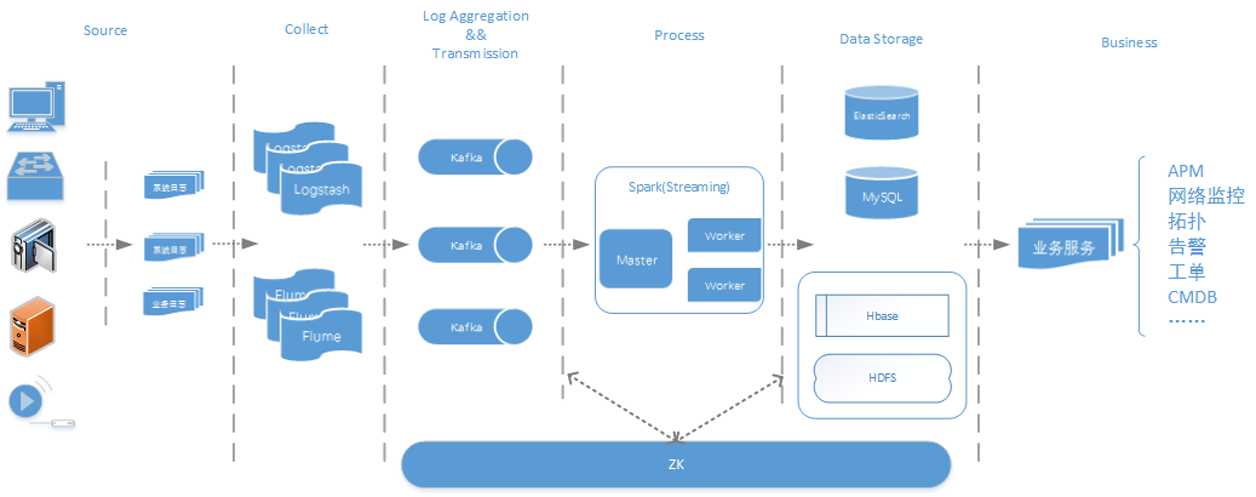
Hadoop并非孤立的系统,其周边有丰富的生态工具:
- Hive:基于Hadoop的数据仓库,提供SQL-like查询语言。
- HBase:分布式列式数据库,支持实时读写。
- Pig:数据流处理语言。
- Sqoop:关系型数据库与Hadoop之间的数据传输工具。
- Flume:日志收集系统。
- ZooKeeper:分布式协调服务。
四、搭建Hadoop环境
1. 准备工作
- 操作系统:Linux(推荐Ubuntu或CentOS)
- Java环境:JDK 8及以上
- 多台机器(或虚拟机),配置SSH免密登录
- 下载Hadoop发行版(如Apache Hadoop 3.x)
2. 安装步骤(以伪分布式为例)
- 安装Java:配置JAVA_HOME环境变量。
- 创建Hadoop用户:专门用于运行Hadoop。
- 配置SSH免密登录:ssh-keygen生成密钥,追加公钥到authorized_keys。
- 解压Hadoop:将下载的tar包解压到指定目录。
- 配置环境变量:在~/.bashrc中添加HADOOP_HOME和PATH。
- 修改配置文件:
- core-site.xml:指定HDFS的默认名称和临时目录。
- hdfs-site.xml:设置副本数(伪分布式为1)。
- mapred-site.xml:指定使用YARN作为资源管理器。
- yarn-site.xml:配置YARN相关参数。
- 格式化NameNode:hdfs namenode -format。
- 启动Hadoop:start-dfs.sh和start-yarn.sh。
- 验证:通过jps查看进程,访问NameNode Web UI(默认50070端口)。
3. 完全分布式集群搭建
- 准备多台机器,规划角色(如master运行NameNode和ResourceManager,slave运行DataNode和NodeManager)。
- 配置 slaves 文件列出所有DataNode节点。
- 同步配置文件到所有节点,并分别启动。
五、数据处理及存储服务实践
1. 数据存储:HDFS操作
- 命令行操作:
- hdfs dfs -mkdir /user/data 创建目录
- hdfs dfs -put localfile /user/data 上传文件
- hdfs dfs -ls /user/data 查看文件列表
- hdfs dfs -cat /user/data/file 查看文件内容
- hdfs dfs -get /user/data/file localfile 下载文件
- Java API操作:通过FileSystem类进行编程访问。
2. 数据处理:MapReduce编程
WordCount示例:
- Mapper:继承Mapper类,实现map方法,输出<单词, 1>。
- Reducer:继承Reducer类,实现reduce方法,对相同单词的计数求和。
- Driver:配置Job参数,提交作业。
打包为jar,使用hadoop jar命令提交到集群运行。
3. 使用YARN管理资源
提交作业后,可通过ResourceManager Web UI(默认8088端口)查看作业运行状态和资源使用情况。
4. 数据仓库服务:Hive入门
- 安装Hive,配置元数据存储(如MySQL)。
- 启动Hive CLI,创建表,加载数据(数据存储在HDFS上)。
- 执行HiveQL查询,自动转换为MapReduce作业(或Tez/Spark)。
5. 实时存储:HBase入门
- 安装HBase,配置hbase-site.xml。
- 启动HBase,使用shell创建表、插入数据、扫描查询。
- 通过Java API进行编程访问。
六、常见问题与最佳实践
- 内存不足:调整YARN容器内存和MapReduce任务内存参数。
- 数据倾斜:合理设计分区,使用Combiner,或采用二次作业。
- 小文件问题:使用SequenceFile或Har归档,或定期合并。
- 安全:启用Kerberos认证,配置SSL传输。
七、
Hadoop为大数据的存储与处理提供了可靠、可扩展的基础框架。通过本指南,你已了解HDFS、MapReduce、YARN的核心概念,掌握了环境搭建和基本操作,并初步接触了Hive、HBase等生态工具。后续可深入学习各组件的高级特性,并结合实际业务场景构建端到端的数据处理流水线。大数据之旅,由此启程。